B站AI无限竞技场上线:GPT-6霸榜,国产模型占三席
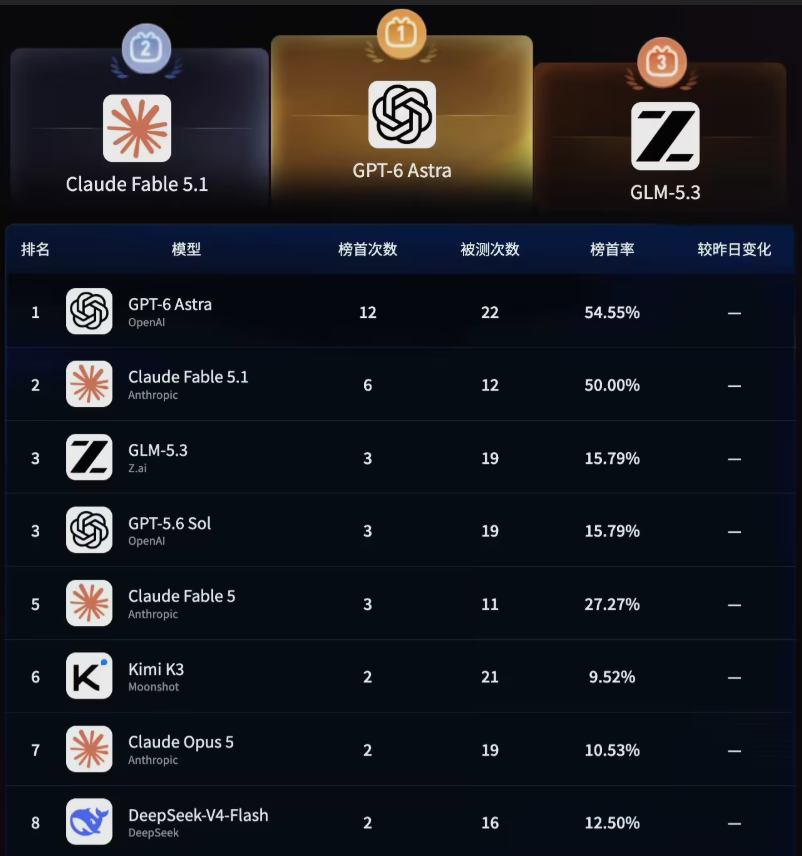
无限竞技场”大模型测评榜,并同步公布了首轮模型排行榜。获得“榜首次数冠军”;前五名中,国产大模型占据三席。不设命题限制,用真实工作流说话平台涌现出大量覆盖不同领域、维度与主题的测评内容,形成了从发布到讨论、测评、使用、求助再到共建的内容生态。
.B站推出AI无限竞技场, 这个活动让UP主使用真实工作流与上百个大模型展开竞争, 其中GPT-6 Astra获得了冠军, 前五名中有国产大模型占据三个席位, 这值得深入看。
竞技场怎么玩的
B站在今年9月份的时候, 正式上线了一个叫做”AI无限竞技场”的新东西。这个活动的核心玩法是这样的。它让在B站上各个分区里活跃的UP主们。用他们自己领域里面的真实工作流来作为命题。然后会让上百个大模型在同一场竞技里面去拼个高下。排名的更新是实时的。目前已经持续地面向全站所有的UP主开放报名了。
这次进行的测评, 它是涵盖了包括代码、推理、协作还有知识在内的多种主题范畴, 它是不设定什么命题限制的, 这就意味着在后面发布的榜单是会越来越厚的, 每一个区域都有可能产生出新的对比数据来。
谁拿了第一
在首轮进行测评的这10位UP主那里, GPT-6 Astra拿了一个榜首的位置, 它把GLM-5.3此前拥有的”榜首次数冠军”这样一个头衔给抢了过去, 它成为了新的第一, 这个结果在一个评论区里面, 引发了一波讨论。
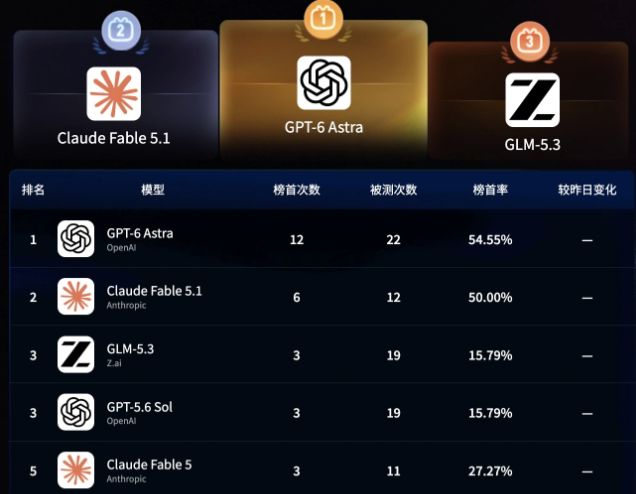
在前五名的榜单里, 像Kimi、豆包、千问这样的国内大模型占据了三个位置。它们和GPT-6 Astra、Hy这些模型之间是分庭抗礼的局面的。从整体上来看, 相互之间的差距已经变得非常小了。这基本上意味着大家都属于同一个梯队了。
国产模型杀到哪了
那个榜单是把Kimi、豆包、千问还有Hy这些主流国产模型都包含在内的, 它在代码生成这一块以及在中文知识类的测评里面表现得非常突出, 它多次跻身到那个前三甲的行列里面去, 这样就能够说明本土模型在中文语境之下的那种适配优势正在被实测来验证。
数据显示, 过去一年B站AI知识内容的消费时长同比增长了百分之七十二, 月均有超过一点九亿的用户观看AI相关内容, 国产品牌的讨论热度和使用量确实处于快速攀升的状态。
为啥不搞跑分
传统的跑分模式, 采用的是标准题目搭配标准答案的形式。不过, 在实际的开发工作中, 并没有人只询问一个单独的问题。B站采取了这样一种做法, 让UP主使用真实的场景来出题。
这些真实例子, 具体体现在调试bug、编写周报、以及制作完整的技术方案等方面。这样的情况, 其难度和复杂性, 已经远远超出了基准测试的范围。
有个别模型在评测环节可以取得九十分的成绩, 可一旦真正投入到了实际协作的流程之中, 它们就很有可能出现停滞不前的现象, 真实的业务工作情景才可以把那些不足之处给揭示出来, 这恰好也就是竞技场最具代表性的优势所在, 相较于单纯地查看某一个数值而言, 这种做法显然具备更高的实用价值。
内容生态长什么样
哔哩哔哩平台在人工智能内容的发布环节、讨论环节、测评环节、使用环节, 直至求助环节、共建环节, 已经形成了一个完整的闭环链路。这里聚集了大量覆盖不同领域和各种维度的UP主群体。在这些群体的内容产出中, 不仅仅仅限于进行相关的测评工作, 还包含了大量的实操性教程分享以及在实践过程中记录的翻车案例。
这个竞技场更像是一个社区实验场, UP主在评论区互相拆解结果、质疑排名, 把一次测评变成了一场持续参与的事件, 互动密度远高于传统评测文章。
接下来怎么看
榜单这件事情会持续地进行更新, 在后面会有更多的模型加入到里面来, 也会有更多的测评主题加入进去, 所以排名随时都有可能会被翻盘, 千万不要把第一轮的结果当成最终的定论, 要多观察好几轮, 然后再下一个判断, 这样会比较靠谱一些。
对于普通人来讲, 没有必要去纠缠到底哪一个模型是最强大的, 而是应当去观察在自己经常使用的场景之中, 哪一个模型的表现是比较优秀的。选择工具的这种行为并不是在进行信仰的选择, 只要能够满足使用需求、让自己感到方便顺手并且在操作的时候不会出现卡顿的情况就就可以了。
请问在日常使用大模型的时候, 你最经常处理的场景究竟是什么? 在这一次的排行榜结果之中, 哪一个具体的情况是最让你感到意外的? 请在评论区进行交流和谈论, 如果觉得这个内容是有用的话, 就点击点赞以及将其转发给那些目前还在挑选模型的伙伴们。