B站AI大模型实测排名出炉:GPT登顶,国产杀进前五
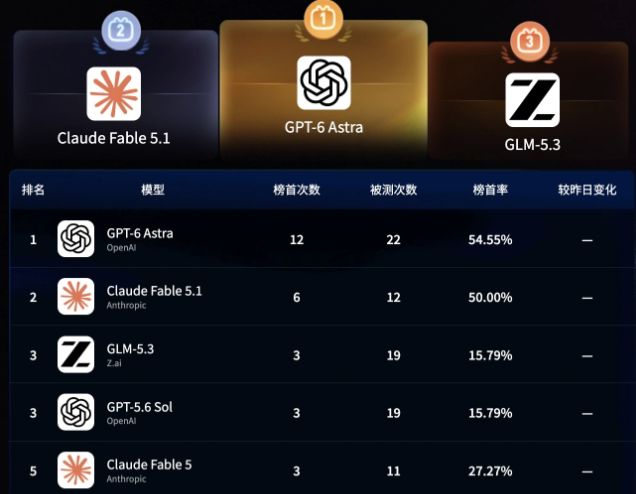
无限竞技场测评榜,并同步亮出首轮排行榜。GLM-5.3压在身后;前五名里国产大模型占了三席,和海外巨头贴身肉搏。这块竞技场和传统跑分榜的玩法不一样。里把实际差距摊开给人看。想做的,是把自家的社区生态变成大模型走向大众的另类裁判台。
当前的跑分排行榜已经无法跟上模型更新的节奏了, 于是B站直接采取了让10位UP主使用真机进行相互比较测试这一做法, 最终的结果显示GPT-4取得了胜利, 但是优势并不是特别明显, 国产模型紧紧地跟在后面。
竞技场怎么玩
B站把上百个大模型拉到了同一个广场, 覆盖了代码、推理、协作、知识等方向, 10位不同分区的UP主自主出题, 用自己真实的工作流和专业场景来进行考核, 不再使用固定的测评模板。
我们把Kimi、豆包、千问、Hy等等这些主要的模型, 全都放到了对比里去。排名的结果, 是跟着时刻更新的。只要有了新的模型上线, 我们就毫不犹豫地把它加进来。那个用来报名的通道, 现在是保持着一个敞开状态, 没有任何时间方面的限制, 所以任何在B站上面做创作的人, 都有资格去提交自己做的实测视频。
GPT-4凭什么坐头把交椅
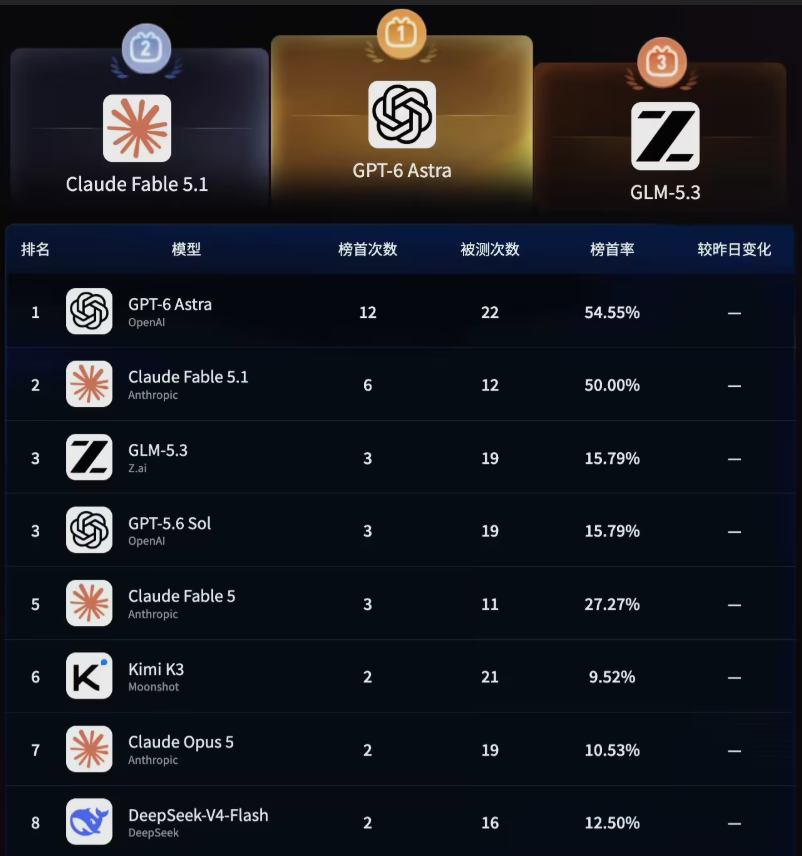
“登顶次数”这一个指标是非常关键的。GPT-4拿到的可不是单次的最高分数值, 而是在多个轮次以及多种不同场景之下, 能够始终保持输出结果为排名第一的这个情况的次数是最多的。特别是在代码补全这一块功能上, 还有处理那些很长的逻辑推理链条的题目时, 它的优势表现得最为明显。
但是一, 第一名的位置并不表示就是彻底的碾压形势。模型GLM-5.3跟得非常的紧, 在一些中文的应用场景, 还有日常协作的题目上面, 出现了反超的情况, 这两家之间的实际差距已经缩到了用肉眼看就可以发现变小的程度。
国产三席到底强在哪
在前五名之中, 国产产品占据了三个职位。这些产品在短文本生成、中文语境理解以及本地化办公场景等表现优异, UP主管家实测后反馈表示可以直接使用, 无需修改提示词, 因此贴合程度是它们的核心优势所在。
不足的地方同时也显现出来了, 在进行跨领域的长链条推理以及在复杂的代码工程任务上, 国产模型偶尔会出现断裂的情况, 这次能够登上榜单, 主要是因为在大多数的日常场景下已经足够使用, 距离在所有场景中都能够完全胜任的目标, 还相差一定的距离。
为什么敢不设固定维度
传统的跑分方式, 采用的是固定的题库以及配套的既定标准, 这就致使模型团队能够针对这类固定配置去进行专门的分值刷取工作;而在B站的平台生态之中则完全不同, 其机制是让用户中的创作者去独立地自行出题,在这种情况下, 有的人负责考查代码编写能力, 有的人侧重考查方案制定水平, 还有的人专注于测试段子撰写技能, 由此便形成了题目内容极其丰富且多样的局面, 使得参与者根本无法实现提前准备这些考题的行为。
趣味脑瓜洞题型也会记分的。模型能不能接住要求给猫写十四行诗的指令, 然后再翻改成文言文这种方式, 比起单纯跑分更能说明真实使用的感觉到底是不是真的好。
B站押注的底气
在过去的那一年里面, B站上的AI知识内容消费时长实现了同比增长72个百分点, 每月平均观看AI内容的用户人数已经超过了1.9亿。围绕模型发布、讨论、测评、求助的内容已经自成体系, 用户基本盘够厚。
模型更新的迭代速度是非常快的, 以至于发布的节奏太快, 跑分榜根本来不及跟上更新。因此, 我们把评测的评判权利交还给了真实的创作者, 以及真实的workflow工作流。这样的做法反而更接近用户心中一直存在的那句疑问, 也就是到底哪个才是好用的产品。
这场擂台能撑多久
如今的大模型更新得特别快, 差不多每过半年就要推出一个大版本的作品, 所以今天还排在榜首的那个, 等到下个月的时候, 很可能就会让更新出来的新给比下去。因为采用的是开放报名的这种机制, 那个排行榜始终都在发生变化之中, 根本不是只是拍摄一张静态的图片, 然后就直接悬挂在墙上去的。
对于广大普通用户来说, 再也不用自己一个一个去试着用那些工具了。观看up主制作的实測视频, 相比查看官方的基准测试数据, 更加具有直观性, 而且也显得非常可靠。你平时最经常使用哪一个模型呢? 请在评论区进行交流讨论, 顺便点击一下赞这个按钮, 好让更多的人能够看到这里的内容。