Step5 Preview全量开放:600B参数达K3级性能,支持百万上下文
级别的性能,性价比非常高。日还将发布完整权重模型。上下文和图文输入。内核美元。天天。接近;不过实际使用速度不算快,若后续免费用户增多,速度可能还会下滑。
昨天阶跃星辰推出的Step 5突然杀出, 拥有600亿参数的模型在K3级别的跑分中达到了2.8万亿, 今天全量开放API还能白嫖75天, 国产大模型性价比的天花板直接被掀了。
参数架构与开放时间
第5步采用了稀疏的混合专家架构, 其中的总参数量达到了600B。在每次推理的时候仅仅激活27B的参数量, 它还支持100万Token长度的上下文处理以及图文输入的功能。阶跃星辰已于9月19日将API调用进行了全量开放操作, 并且在10月15日会放出完整的权重模型。
对于中小团队以及独立开发者这类群体而言, 他们完全不需要去租赁那些拥有点二八万亿参数的超大型号模型。相反, 他们只需要花费原先预算当中微不足道的零头部分, 就能够顺利拿到接近顶级水平的能力表现。在单任务接入这个环节上, 相关的直接成本可以被大幅度削减, 最终直接被砍到了只有之前的十分之一水平。
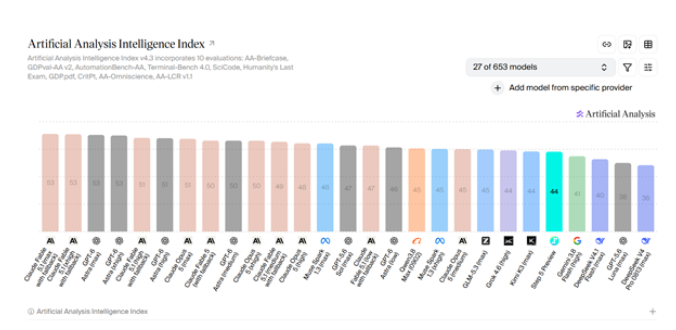
跑分与单次成本
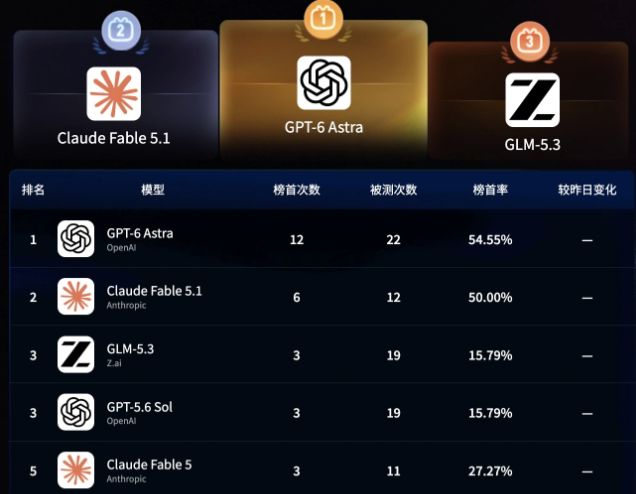
在AA榜单上, Index得分是44分, 这个分数与Kimi K3 Max持平, 输出速度大约为100Token/s。每项任务的成本是0.71美元, K3 Max需要花费2美元, 前者比后者便宜了接近三分之二。
不过, 多位开发者进行了实测并提供了反馈。他们表示在并发的高峰期间, 速度会出现明显下降的情况。后续随着免费用户持续地涌入, 延迟大概率还会进一步上涨。因此, 在高峰时段建议采取错峰调用的方式。
24小时长任务实测
到了第5个步骤的时候, 这套系统是可以连续不间断地持续工作24个小时, 并且自主地完成一套针对H100型号的图形处理器核心进行的优化任务, 它自己会去修改源代码, 自己会去执行相关的测试流程, 自己会去比较运算出来的结果, 然后基于这些结果再进行迭代升级的动作, 在经过22个小时的努力之后最终获得的分数达到了508分这样高的水平, 而在相同的时间段之内同期推出的Opus 5模型所取得的得分则是493分。
在另一组的实验里面, 它进行了自主设计, 然后使用了训练数据, 这种做法使得模型 Qwen3-30B-A3B 在基准测试上面获得的准确率被提升到了60%, 这个数值是从原本的53.3%拉上去的, 同时达到了和 Opus 5持平的水平, 并且在这个过程中消耗的标注 Token 数量出现了明显的减少。
注册福利拆解
新用户进行注册就送那个99元的套餐, 登录直接就能得到15天的使用额度, 然后再完成首次的API调用, 这又能再加15天, 每邀请一位好友来注册, 还可以再获得15天, 不过邀请部分累计的上限是45天。
总福利叠加之后的最高天数达到了75天, 在9月19日阶跃星辰官方同步开放了注册入口, 个人开发者可以不花钱就能跑通过一个完整的项目流程。
社区真实反馈
目前社区的人普遍认为, Step 5要想完全赶上K3的表现, 还有一定的差距在它面前。它整体的表现情况, 更加接近于V4.1 Flash的水平。在处理复杂且多步式的推理任务时, 以及在生成长代码的时候, 偶尔会出现卡住不动的情况。
它的定位, 并不是刷榜工具。而是一套够用且便宜的 productivity 方案, 这套方案适合数据清洗、文档摘要、日常编码辅助这些高频、低成本的场景。
后续关键节点
10月15日这个时间点很关键, 完整权重模型会在这个时候发布, 模型一旦开源了以后, 大家在本地部署的门槛就会再降低一个等级, 那些对数据隐私问题比较敏感的行业, 它们的吸引力会变得明显更大。
阶跃星辰接下来要解决的核心问题, 是推理速度随着用户数量的增长, 到底应该如何保持稳定状态。如果延迟的时间过长, 导致体验变差被拖垮, 那么本身的性价比优势, 也会被渐渐地消耗掉。
你现在打算用Step 5来跑什么项目, 免费期够用不够用。去评论区聊一下你的实际体验感受, 觉得有用的话就点赞转发给还在找便宜大模型的同事。