阶跃星辰Step5Preview:AI编程成本降至1/8,10月开源
阶跃星辰发布新一代旗舰基座模型Step5Preview,重点面向AI编程、软件工程、专业知识工作及金融等场景,提升模型在真实世界Agentic任务中的综合表现,并进一步优化智能、成本与效率之间的平衡。Opus5的1/8,计划于10月15日正式开源。
花掉八分之一的钱, 跑出全球前三的智能。阶跃星辰这次, 把AI编程和金融场景里头那个“贵”字, 直接砍掉了。
全球开源模型前三意味着什么
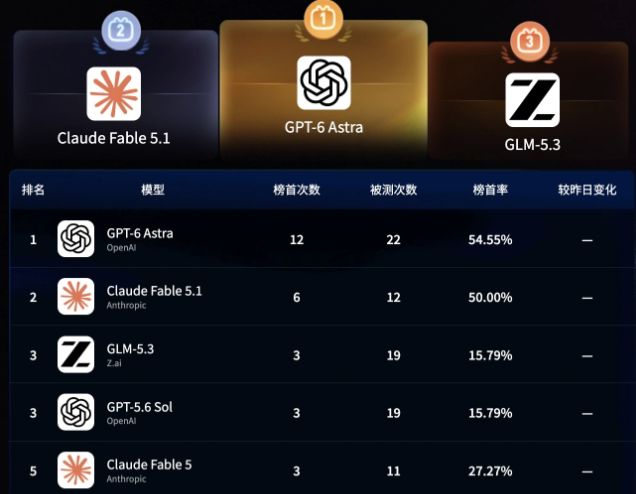
在AA综合智能指数这一榜单里头, 此种模型能够跻身到全球前三的那个排位当中去。在这个排行榜的头部区域, 时间长久以来都是被Llama以及Mistral所牢牢把持着的。国产开源的东西能够进入到这个前三名的行列里去, 这说明在实际的任务处理能力方面, 已经追平了的多数闭源模型的相应水平了。
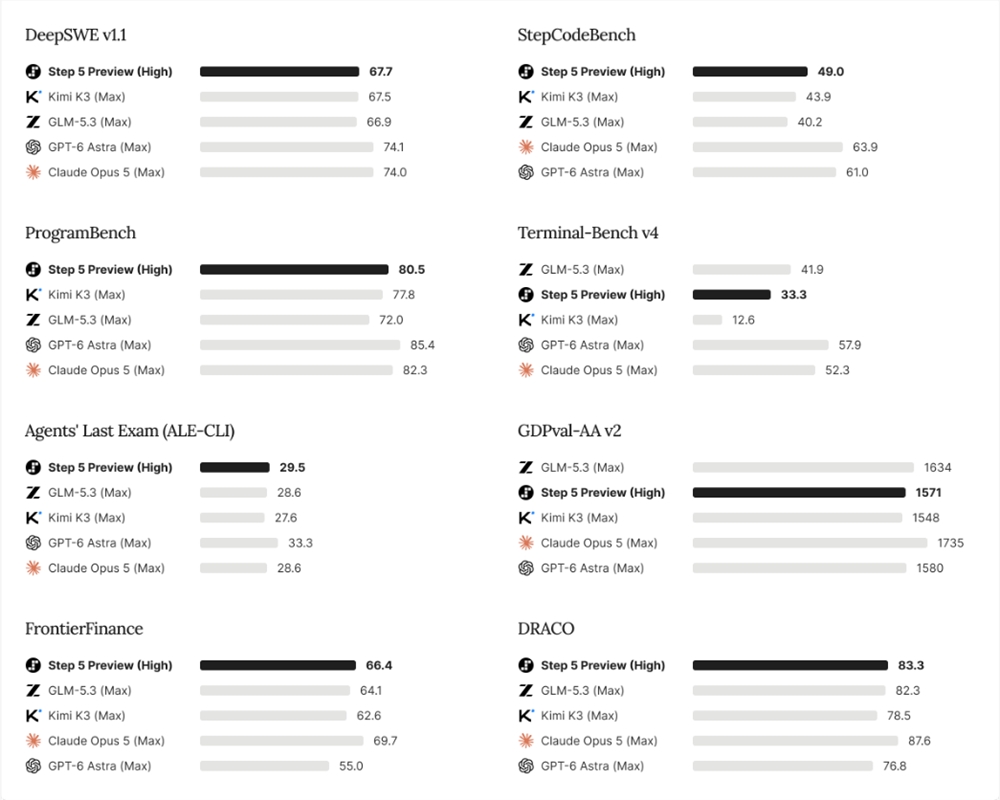
重点并不在于跑分, 而是该模型在编程、软件工程、专业知识以及金融这四类高价值场景当中, 已经完成了专项优化。此模型并非仅仅表现为智能的“聪明”, 而是针对于你们每日所从事的那些复杂工作, 进行了专门的调整与适应。
成本只有Opus5的八分之一
单任务的这个成本, 它仅仅只有Opus5的那个成本的八分之一。
如果我们以每天5000次的代码补全这样的量来作为一个例子去看的话, 那么要是按照Opus5的定价标准来计算, 一年的支出金额都会上升到上百万的这种程度, 可是如果一旦我们换成使用这种新的模型, 那么直接节省下来的费用就会变成十几万元这样的规模, 这点对创业团队来讲, 还有对中型公司来讲, 都构成了一种发生本质变化的影响。
省下的钱变少了, 省下的时间也变少了。27B这个激活参数使得推理的速度变得更快了, 一百万Token这样的一个上下文长度意味着一个完整的代码仓库或者一些几十页的报告材料可以被一次性地放进去处理, 不需要再进行分块和拼接这样的操作了。
稀疏MoE架构怎么实现的
该模型的总参数量是600B, 实际被激活的参数仅为27B, 采用的是稀疏的MOE路线。这个模型拥有600B的巨大“脑容量”, 但在进行每一次推理操作的时候, 它只会调动27B个神经元投入工作, 而剩下的其他部分则继续处于休眠状态。模型所具备的能力并没有遭到削减, 但是算力成本却成功砍掉了一大半。
它原生地就支持文本以及视觉这两种输入形式, 所以你能够直接丢进去一张架构图或者是一張财报截图, 模型是可以看图去理解的, 这在金融研报分析以及软件设计评审这两个场景里面是特别实用的。
帕累托前沿这个说法什么意思
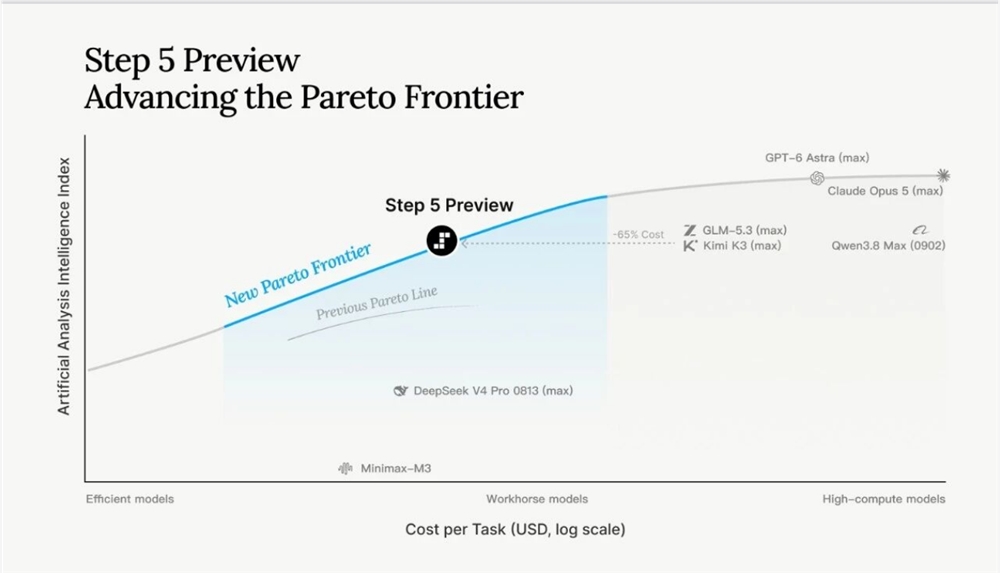
阶跃星辰把它定位成了“主力工作模型”, 这里的核心衡量标准是帕累托前沿, 在同等成本之下把智能再往上提升一格, 或者在同等智能之下把成本再往下压缩一截, 不是进行刷分式的操作, 而是实实在在地去算账。
在过去的时候, 用户只需要花费一元钱就可以购买到具备八十分能力水平的服务或者产品, 然而在今天的情况下, 只要同样的用户依旧只掏出一块钱, 就能够买到拥有九十五分能力水平的服务或者是产品。对于那些需要全天二十四小时全天候不停地运行推理操作的企业来讲, 它们所拥有的总成本的变化曲线是直接发生改变的了。
10月15日开源意味着什么
在10月15日这**一天正式实现了开源**。国内的开发者不需要再去进行翻墙这样的操作, 也完全不用去排队等待Api额度的释放。他们能够直接将拥有权重的模型拉取出来, 并将其顺利部署到私有的集群环境中。
**数据始终都运行在内部网络范围之中**, 并不会流出内网。这对于像金融行业和医疗行业等涉及大量敏感数据的领域而言, 终于具备了将其投入实际使用的具体条件。
当下的实际情况是, 600B总参数量就算仅仅激活27B, 在进行推理工作时, 依然需要依靠多卡的A100或者H100来支撑。但是对于那些已经搭建好GPU集群的团队来说, 边际成本基本上就只有电费支出, 这一部分开销几乎是完全可以忽略不计的。
你们团队在现在运行推理业务的时候, 一年大概要花掉多少钱呢? 如果成本直接被削减到原先的八分之一, 你心里最打算首先拿这个优势去替换哪一个具体的环节? 请大家在评论区里面聊聊这个话题, 如果觉得这个方法是有用的, 就点个赞或者是转发给那些从事技术工作的同事看看。