智谱新出GLM-5.3-FlashX大模型 高性价比快速度企业开发者速看
token,给企业开发者的体验按下了加速键。GLM-5.3-Flash——它靠着同尺寸里最能打的智能水平,在海外内圈了一波口碑,调用量一路往上爬。不只是快,而是把智能、价格、速度这三张牌第一次同时攥在了手里。这条线,意味着它能在不牺牲聪明程度的前提下,把响应延迟压到一个相当轻快的档位。
在过去两年里, 关于大模型处理速度缓慢、等待时间过长的现象, 是企业开发者进行投诉时最为集中的问题所在。
智谱方面此次针对GLM-5.3这一产品, 将其运行速度直接提升至每秒输出两百个词元, 并且在这个过程中, 并没有导致该模型的智能水平出现下降的情况。这种做法实际上相当于解除了在生产环境运行中所面临的那一个最受到限制的瓶颈环节的压力。
200token每秒到底什么概念
在此之前, GLM-5.3-Flash已经在使用的时候发现推理速度比同样大小的其他模型要快很多, 可是还差一点才能感觉到特别顺畅。
GLM-5.3这个模型把最高处理速度提升到了每秒两百个token, 这就意味着有一段五百个字左右的业务摘要需要处理的话, 理论上用不到三秒的时间就能运行完成。对于那些对反应时间要求很高的应用场景来说, 这种实际感受上的差异是非常明显的。
以客服机器人和代码补全这两个场景作为例子来看, 用户等待回复的时间从原本需要花费十几秒的时间大幅缩减到了仅需要两三秒, 这种变化带来的用户体验实现了跨越式提升, 直接上了一个新的台阶。
北京一家金融公司的技术负责人进行了反馈, 据他透露, 在进行内部测试的过程中, 他们将GLM-5.3接入了风控问答的业务流程里, 结果发现单次响应所产生的延迟比之前所使用的技术方案降低了大概百分之六十之多。
GLM-5.3-Flash凭什么先火了一波
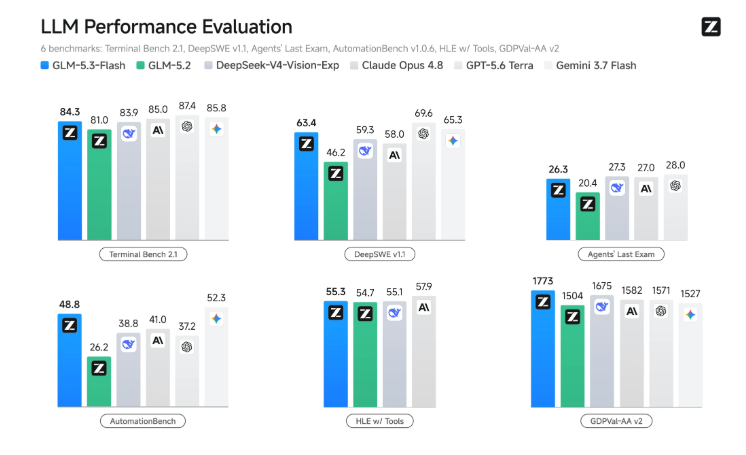
GLM-5.3-Flash 去年是以”Ox Alpha” 这个名字, 先面向海外的开发者开放的。它在 LMSYS Chatbot Arena 这样的平台上, 在同尺寸的那一组里, 长期排在特别靠前的位置。
它靠的是纯粹的智能水平非常强。后来, 海外的开发者社区里的口碑就起来了。模型被调用的数量, 在几个月的时间里, 翻了有倍数之多。智谱的团队就在二零二五年年底时就意识到, 光是跑得快是不够的, 得把整个推理的链路重新搭建一遍。
这股市场需求直接推动了GLM-5.3的立项工作。智谱在2026年的第一季度集中发布了新版本, 把Flash阶段中积累下来的用户反馈, 一条条地落实到了模型架构以及推理引擎里面去, 这等于就是用市场方面的需求来倒逼了一轮技术层面的创新与改变。
10万张国产芯片怎么撑起来的
GLM-5.3模型的推理算力基础, 是建立在十万张国产人工智能芯片上面的。智谱公司从2024年开始, 就和国内那些生产芯片的企业一起进行联合优化工作。他们针对模型运行的具体场景, 在指令集这个层面做了专门性的适配。
这绝对不是简简单单地把模型放上去就运行那么简单, 而是要去改动数据流通的流量大小, 以及修改计算操作系统的调度逻辑安排。这一套基础设施的建设, 到了2025年时候把基本版本跑通了, 而GLM-5.3则是第一次在满载十万张这样的计算卡的情况下, 正式面向外界提供相关的服务使用。
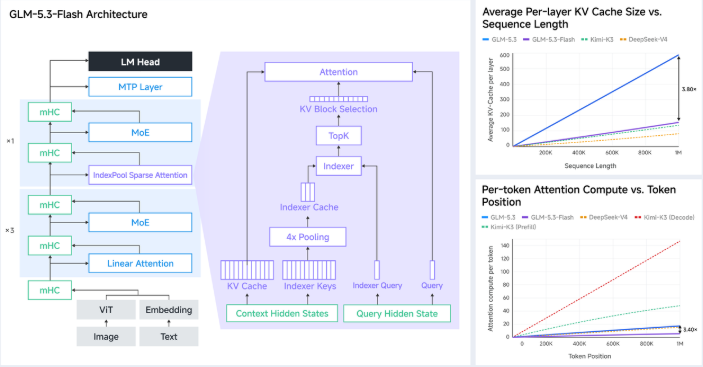
智谱除了芯片层之外, 在基础设施建设侧, 也就是Infra侧, 还投入了对推理框架的深度定制工作。这其中包括了KV Cache管理、动态批处理能力, 以及节点间的低延迟通信技术。
官方并没有详细披露具体参与的人员数量。但是从已经公开的专利信息来看, 可以观察到明显的增长趋势。在2025年到2026年期间, 智谱在推理优化方向上所提交的专利申请量翻了一倍。
智能速度价格三张牌同时攥住
过去大家在选大模型的时候, 基本上面临的是一个取舍的局面, 想要智能好点的话就不得不牺牲一点速度, 想要速度快一些就得投入更多的资金, 想要价格低廉一点只能忍受它运算速度慢。GLM-5.3这款产品第一次把这三个方面的变量都控制在可以接受的范围内。
它的智能水平已经达到了和Flash阶段相同的水位, 运行的速度提高了一倍, 而且它是按照token数量来计费的一种收费标准, 这个单价并没有因为有了速度的提升而进行加价, 所以企业们在计算整体花费账目的时候所感受到的压力就小了很多。
以那些一个月调用量达到五亿token级别的电商企业来做粗略的计算, 如果把模型切换为GLM-5.3的话, 在处理同样的业务量的过程中, 因为推理等待时间被大幅缩短了, 所带来用户转化率提升的效果, 基本上足以抵消掉API调用的相关成本支出, 这种情况对于那些规模相对较小的开发团队来说就显得非常友好, 使得他们在使用的时候, 就不必再针对运行速度是否足够快以及使用费用是否在承受范围之内这两个问题, 来发生反复的权衡和纠结了。
API上线后企业怎么接入
GLM-5.3的API已经正式开放了。开发人员在智谱开放平台创建应用以后, 在调用代码的时候, 把Model Key填写成”GLM-5.3-“这样的字符串, 这样系统就会把请求路由到那个新的模型上面去进行服务。
验证身份的过程采用的是标准的Bearer Token方案。官方提供的软件工具包也就是SDK, 支持Python这种编程语言和Java这些语言的使用。相关的技术文档里面, 同时也给出了流式传输方式的处理示例以及非流式的常规调用示例两种参考代码。整体接入的流程跟之前在调GLM系列的时候相比, 没有本质上的区别, 对于老用户来说, 基本上也就是改一行字符串而已。
针对那些已经在使用GLM-5.3-Flash的团队, 强烈建议在测试环境中先行进行一轮压力测试, 并且需要把重点放在监控P99延迟以及确定并发上限这两个方面上。
而对于新接入的企业来说, 可以直接选择使用GLM-5.3来启动项目, 这样能够省去中间的一次迁移步骤。关于官方是否公布免费额度的变动情况, 目前是没有公开的, 所以企业开发者应该去关注平台控制台里的用量通知信息。
快不等于稳 生产环境还得看什么
当处理速度提升了以后, 新的限制条件常常会转移到并发的稳定性以及长文本上下文的连贯性上面去。
有的进行测试的团队反映说, GLM-5.3这个模型在单次请求的时候, 表现出来的延迟数据是非常好看的, 可是一旦把并发数量压到了超过500的水平, 那么P99这种统计尾部分位的延迟指标就会出现非常明显的波动和峰值跳动现象。
要是企业所面对的应用场景是面向普通用户的、有着高并发访问要求的服务入口, 那么在正式上线投入使用之前, 必须要去做那种按照时间段分布进行的压力测试工作, 千万不要只盯着平均数这一个指标来看待问题。
除此之外, 国产芯片算力规模的扩大步伐也是一个不确定的因素。十万张卡这个数量级是预计在今年年中达到的状态, 而未来会不会继续增加显卡的数量、具体会把这些硬件部署在哪些区域节点上, 这些情况都会对高峰时段的服务等级协议产生直接的影响。
所以建议相关企业去和智谱公司的商务团队核实清楚现阶段的容量保证措施以及出现故障时的切换应急预案, 务必把相关的条款白纸黑字地写进合同里头, 千万不要等到问题真正发生之后才再来商议。
在实际开展业务的过程中, 关于模型单次响应延迟的底线究竟会设置在大概多少毫秒这个具体数值上? 请你前往评论区来聊一聊你所处场景下的具体情况以及相关的数字数据, 如果觉得这些信息具有参考价值的话, 请进行点赞操作, 并将其转发那些还在为技术选型问题而感到纠结困扰的朋友。