千问新一代全模态模型上线 音视频多模态处理能力大幅提升开放体验
平台开放体验。创作、影视制作与解说、音视频转图文摘要及音视频对话等需综合处理多模态内容的工作流。提升超26%。每小时音频输入价格降幅超98%,音视频输入价格降幅超93%。降至15.30%,相对下降约40.7%。版本为首个支持听声辨位的全模态大模型。
在过去, 想要制作一段视频解说或者是剪辑一条音乐电视, 大家往往得忍受漫长的等待。这个过程不仅需要花大量时间让AI把音视频素材彻底理解透彻之后才能输出最终结果, 而且还要面临排队等待以及高额费用的双重折磨, 这确实能让人头疼不已。
直到9月18日千问推出了Qwen3.8-Omni-Flash这一版本, 才真正把这条瓶颈路给打通了。这个新版本具有强大的全模态输入能力, 文本、图像、音频这老三项加上视频新加入的要素, 它能够一口气全部接收处理进来。同时它还具备1M token规模的长上下文处理能力。
在价格方面, 其API服务的收费比上一代产品直接削减了九成以上。
四种输入一口全吃
千问在18日, 通过千问AI平台, 正式开放体验了这个名叫Qwen3.8-Omni-Flash的新一代原生全模态模型, 这是它发布的消息。
这个模型支持文本、图像、音频和视频这四种模态同时输入, 上下文窗口能拉到一百兆token那么大的空间, 这意味着一部两小时的电影, 加上它的旁白, 再加上字幕, 模型能一口气读完整个内容, 然后再给出它的结论。
现在平台的入口已经打通了, 用户只要登录千问AI平台, 就可以直接调用这个功能, 这一点是已经做到的事实。
音视频工作流全覆盖
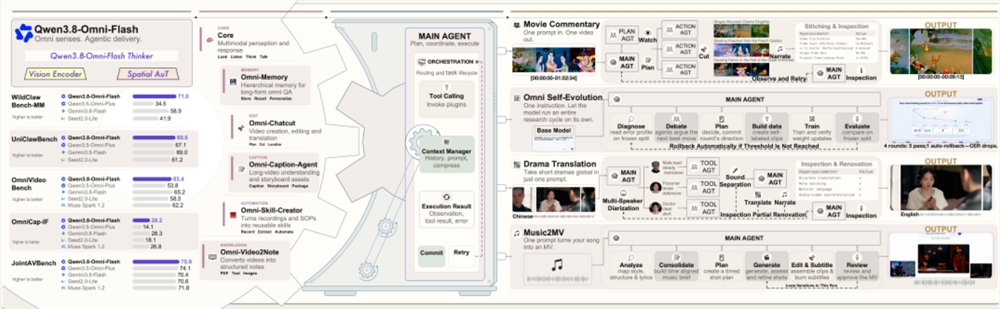
官方将这款模型的主要提升点, 重点放在音视频领域。它具体涉及到的场景包括: 自动理解视频剪辑所用的素材、按照节奏节拍生成音乐视频、给影视片段配上自动生成的解说文字、把音视频的内容转换成图文摘要, 以及直接与音视频进行“对话”。
这意味着过去需要通过组合使用三到四个工具才能完成的整个创作流程, 现在可以利用一个模型接口来全部承接和处理。
三十项评测平均提升超两成六
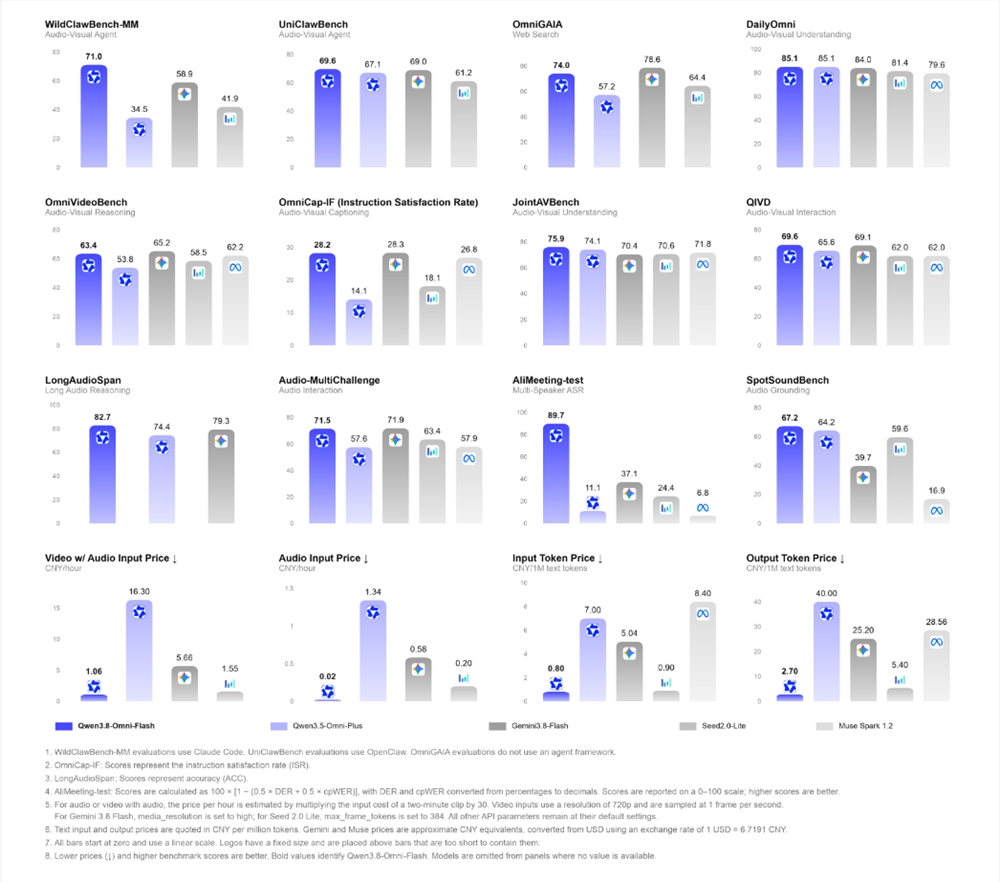
千问团队一共跑了累计三十项的评测, 结果发现, Qwen3.8-Omni-Flash的平均分比上一代的Qwen3.5-Omni-Plus要高出了百分之二十六以上。我们来把它拆开细看, 音视频Agent的任务提升了36.5分, 长程任务提升了22.3分, 这样综合得分就到了69.6分, 在基础能力层面, 通用知识提升了8.3分, 指令遵循的能力提升了9.6分, 指令安全的CSR数据提升了8.5分, ISR的数据也分别提升了14.1分。在语音识别这一端, DER这个指标已经从88.11降到了3.35, cpWER这个指标也从89.61降到了17.18, 基本上已经把这个误识别的问题压到了一个可以拿来商业使用的水平里面。
价格砍到几乎白嫖级别
官方公开的信息显示, API的定价发生的变化相当直白。具体来看, 每小时音频输入的价格降幅超过了98%。同时, 音视频输入价格的降幅也超过了93%。按照这个趋势进行换算可以得出这样的结果。如果使用工具将一条时长为五分钟的视频投入其中进行摘要和解说处理。
原本需要支付几十元的调用成本。现在已经被压缩到了几毛钱以下。对于那些从事批量短视频制作或者影视二次创作工作的团队而言。这一条价格线的作用基本等同于把试错成本控制在了零的范围以内。在这样的情况下。即便每月能够产出几百条相关作品。大家也不会对账单产生过多的担忧了。
开源长程框架加Token省四成半
为了支撑长途的工作流程以及实时的交互活动, 通义千问这次同时扩展了Qwen-MM框架, 并且开源了Qwen-Live。在评测模式的状态下, 准确率提升了, 从原来的63.4升到了67.8。另外, 单次任务所消耗的Token数量也降低了, 从145736降到了79117。这降幅大约是45.7%。所谓开源, 就是指的开发人员可以直接获取Qwen-Live这具体的素材, 进而凭借着自己本地的计算资源去完成搭建实时音视频智能体这般事情的这一项工作, 而不需要将所有的请求都发送给第三方的应用程序接口去处理, 通过这种让自己本地运行的方式来进行相应的操作, 也能够起到有效控制成本方面的作用。
模型自己给自己造数据
更值得拿出来仔细说道的一步是, 千问把这个模型直接推到了研发环节的本身上面去。
团队那边是让模型自己在12个小时之内, 把这事儿给自主完成了, 包括了评测集的选择、数据的构建, 还有4轮次的迭代, 最后累计出来3413条训练数据, 这样就把Qwen2.5-Omni-3B这个四川话识别的字符错误率给压了下去, 从原来的25.79%, 一下子降到了15.30%, 相对下降了大概40.7%的样子。也就是在同一个时间点, 他们把那个支持“听见声音就能辨别出位置在哪儿”的版本也给推出来了。这个版本是全模态的大模型里头的一个头一份儿。它是第一个能做到根据那声音打哪儿来的地方, 给做一个有关于空间上位置判断的模型。
你平常在搞视频或者音频内容制作的过程中, 最盼着AI能帮忙把哪一个环节给自动搞定呢, 快到评论区去聊聊, 顺手点个赞, 并且把这个内容转给你的那些还没摆脱手动剪辑的朋友让他们瞧一瞧。