DeepSeek V4.1Flash发布:552B参数轻量化模型,速度更快成本更低
作为一款具备原生多模态视觉理解能力的轻量化模型,其设计初衷旨在实现更高的能力上限、更快的推理速度、更大的吞吐量,并具备向更大参数模型扩展的潜力。由于采用了输入和输出不对称的设计,其输入激活仅有8B,输出激活为16B,使得整体成本显著低于同尺寸的已知模型。对相关产品线和计费策略进行了系统性调整。
模型架构大突破
深度求索今日正式推出V4.1模型, 此为其全新模型结构系列里的最小尺寸成员, 该模型具备原生多模态视觉理解能力, 设计初衷是实现更高能力上限、更快推理速度和更大吞吐量, 更保留向更大参数模型扩展的潜力。
采用552B参数的MolMoE混合专家架构V4.1, 引入全新的结构创新。输入激活输出8B, 16B, 这种不对称设计让整体成本远远低于同尺寸已知模型, 配合更大规模的全新预训练方式和强化学习后训练, 智能水平成功超越包括V4Pro在内的一众旗舰模型。
成本压缩创纪录
新一代模型大幅压缩KV Cache缓存大小, 对高带宽内存HBM需求降低至四分之一之数, 固态硬盘SSD对应的需求缩减至八分之一。这一改进在Agent使用的特殊场景中效果尤其显著, 乃因上下文存储及缓存命中引发的相关费用所占比率居高不下, 缓存压缩结束后这类任务的实际使用成本会大幅降低。
按统计说来, 对照初代的模型呀, V4.1的KV Cache已然缩降至原来的四百三十七分之一大小这意头, 企业要是处于大规模部署的时候, 硬件投入跟运维的成本一概都将浮现显著下滑,替AI应用的普及搬掉了重要关卡。
产品线路大调整
新模型上线后, 官方对相关产品线及计费策略开展系统性调整;V4.1同步上线API, 用户将模型名称修改就能直接调用;旧版本的V4Flash与V4FlashExp已正式下线, 旧模型名眼下被临时路由至V4.1上, 保障过渡期平稳运行。
考虑到V4.1在性能费用速度和总用时的方方面面已经全面超越了V4Pro, 官方计划分门别类有步骤下线V4Pro模型。在2026年9月14日十二点之后且在V4.1Pro上线之前, 所有访问V4Pro的请求将全部被路由去向V4.1并皆按其单价计费, 用户无需额外繁琐操作便可享受到顺畅舒适的升级体验。
价格下调惠及大众
依托底层架构创新, V4.1可以用更低的成本服务极多的用户, 针对此举官方顺势降低API定价。让计算资源更合理调度, 新定价持续落实峰谷定价机制, 闲时价格属于高峰时段的一半, 推动用户灵活调度任务实行时机, 新价格在2026年9月10日中午正式开始实施。
这一价钱策略让中小规模公司和个人程序开发者也可以使得起来配置出色的人工智能模型, 原先颇高价格的逻辑推断成本被大幅度压缩之后, 原先仅仅能用以主要业务的程序模型调用办事, 此刻能够安心拓展延伸到更多边界新场景以及试验性质研究程序项目, 非常极限拓展了AI模型利用范围。
生态伙伴齐接入
腾讯旗下多个官方合作伙伴已全量接入V4.1模型, 标志着该模型进入大规模商用阶段, 这些生态伙伴涵盖云计算、企业服务等多个领域。他们的快速接入, 意味着V4.1已经在真实业务场景中验证了其稳定性和实用性, 为用户提供可靠的选型依据。
合作方的广泛支持不止体现在技术层面, 更映射在市场认可度上。当头部平台纷纷选定同一套模型基础设施时, 指示行内标尺正慢慢形成, 后续涌入的新用户应向相较更为成熟的各类工具及更为多元的解决方案生态, 学习成本与适配难度均会出现醒目降低。
性能实测有突破
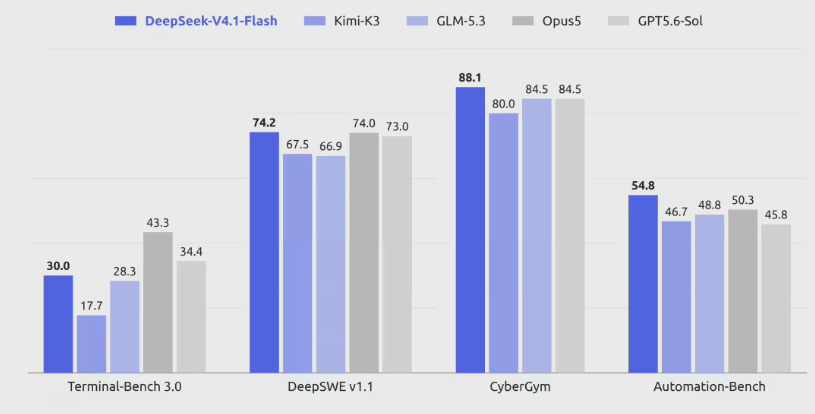
在V4.1的多项基准测试里均展现出强大实力, 它的智能水平超越了包括V4Pro在内的一众旗舰模型, 在使用这款被定位为轻量级的模型时用户能够获得接近甚至可媲美元顶级旗舰模型的表现, 它还打破了以往小模型性能受限的固有认知, 为资源有限的团队提供了全新的技术路径。
针对处理图文任务、处理图表任务及处理手写体任务之时, 多模态视觉能力原生支持让V4.1处理这类任务表现, 相对于客服类业务场景、文档审核类业务场景、商品分析业务这种需要频繁处理资讯视觉场景里, 这个模型可以提供更符合要求的更高效更高质量智能化支持。
V4.1用更低成本实现更高性能, 这对于寻觅性价比的企业来讲意味着什么? 你觉着在小模型能替换大模型的岁月, 还有哪些行业会最先获? 欢迎在评论区分享你的看法吗?