AI决策模型Jev:比LLM快10倍,工单分类成本降至十分之一
在这类任务上比大语言模型快10倍、成本仅为其十分之一。不生成文本,而是直接输出结构化决策结果,供程序直接使用。客服工单智能分类更高效。在每条消息、每次工具调用或每句话上快速、低成本地完成判断。One”模型——专为软件内部快速、结构化决策而设计,而非面向人类的聊天生成。
旧金山有一家初创公司, 公司的名字叫做AI, 这家公司最近发布了一个模型, 这个模型也被取名为Jev, 它并不生成任何文本内容, 而只是回答“是”或者“否”, 以及进行选择题的回答, 它的运行速度比现在的大型语言模型快了十倍以上, 而成本却只有大型语言模型的十分之一, 这种状况直接挑战了那个认为人工智能必须会聊天的默认假设。
不写文本的AI长什么样
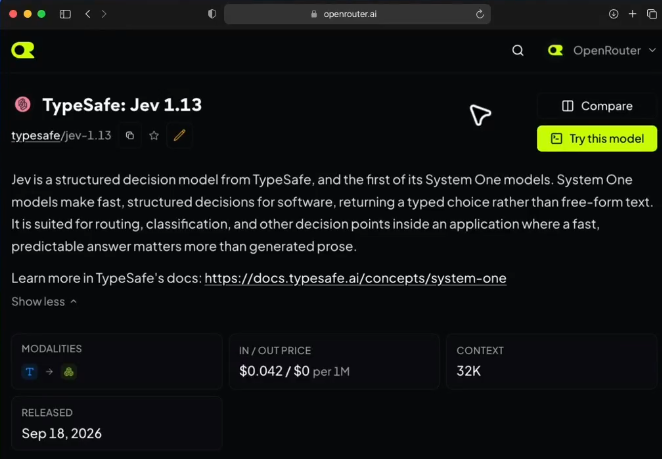
Jev的核心逻辑其实就是把那些复杂的任务, 给拆解成了一大堆是非判断或者是多选的判断。你可以把它理解为像询问“这条消息是不是Bug报告”这样的是非题, 或者“对方是否已经说完”这样的多选题。
每一个判断都独立地输出结果, 再加上一个置信度分数。程序呢就直接去读取这些数据就好了。它不需要再去费力解析一大段自然的语言内容。
这家公司把它定位成一个叫”One”的模型。它的服务对象是软件里面的内部流程, 而不是人类用户。它输出的东西是结构化数据, 不是文字。这种设定省去了生成token的过程, 所以速度和成本方面的优势就从这里出来了。
客服工单分类只需两秒多
在官方进行的演示环节里, Jev针对一批客服消息执行标签分类操作, 涉及的类别包含取消、退款、愤怒以及Bug还有升级这几个方面, 整个过程所花费的时间为2.3秒, 相应的成本大约是0.1美分。
然而, 把相同的工作任务转交给聊天型的大语言模型来执行的话, 大概需要耗费20秒左右, 两者之间的价格差距显得相当明显。
对于那个每天都得处理上万条工单的客服系统而言, 这20秒的时间差, 乘以每天处理的数量总量, 最终就是非常明显的延迟问题和费用方面的差距变化。使用Jev之后, 让分类这个动作从原本需要等待AI回复一段话的状态, 变成了可以瞬间打上标签的状态。
智能体选工具不再卡脖子
当那个人工智能智能体在运行的时候, 它必须从几十个可用的工具里面去挑选出某一个工具, 而传统的处理方法是大语言模型先写出推理的文字内容, 然后系统再去解析这些文字, 这种方式不仅运行速度慢, 成本也很高, 为此Jev把这个选择任务变成了一道多项选择的题目, 让模型直接输出了工具编号和对应的置信度。
当某一次任务执行的时候, 它需要去调用十几次不同的工具, 在每一个调用的环节里节省下来的几秒钟时间以及那几笔微小的费用, 经过不断累积之后, 会使得整个业务流程链条的响应变快并且花费的资金大幅降低, 这种情况在面对那些需要同时处理大量请求的智能体应用场景时显得特别重要。
信息流过滤跑在用户滚动时
你可以把X上面看到的每一条回复, 都看作是摆在面前的一道选择题。你要去分辨它到底是真实的提问, 还是那些流行的观点, 或者是商业推广、情绪上的煽动, 甚至是无意义的捣乱。
Jev这个产品或者功能, 会在用户手指上下滑动并刷新页面的时候, 立刻就能完成这种判断工作。对于那些判定为不好的内容呢, 它会直接帮用户把它隐藏起来。
这种任务的总体规模是非常巨大的, 对于每一条数据, 必须都要去运行一遍模型。聊天类型的大模型如果要做实时内容过滤这样的操作, 其所产生的成本是我们根本承担不起的。正是因为Jev给出的价格分级为每条0.1美元, 才使得逐条进行判断这一方式在经济层面变得真正可行起来。
会议记录里的瞬时判断
在会议进行过程中存在着不间断的交流情况, 此时系统必须做出快速反应。系统需要分析当前的内容指向, 明确这句话是不是专门针对助手提出的。同时, 还要判断对方是否已经把所有话都讲完了。
此外, 要识别语句里有没有具体的需求, 以及这些需求是否需要触发对应的操作步骤。每一次的评估结果, 都会给出一个要么“是”, 要么“否”的最终结论。
传统的方案, 需要等语音全部转换成文字之后, 再去利用大模型做总结工作, 这样做会导致延迟比较高。Jev采用逐句进行判断的方法, 使得会议助手可以在对方刚刚说完的第一秒时间就给予响应, 这样带来的用户体验, 是非常接近真人助理的水平的。
早期试用与API开放
目前Jev已经进入了早期试用阶段, 对外通过API进行调用。开发者拿到手的是一个轻量的接口, 输入问题选项, 就能输出答案和置信度, 这个集成成本远低于接入完整的大语言模型。
公司给出的建议是, 对于业务当中每一个需要进行判断的环节, 要把这些环节拆解成一个个小的问题, 然后把这些问题交给Jev去处理, 而不是让一个大的模型从头到尾把所有文本都生成出来, 这样的一套思路正在改变人工智能工程当中的架构设计。
你是否觉得, 那种“人工智能只管做判断, 却不负责聊天说话”的这个技术方向, 会有可能取代你目前正在用的部分大模型调用功能呢? 欢迎你来评论区里聊一聊, 如果觉得这个观点给你带来了启发, 就点个赞支持一下, 或者把它转给同行看看。