AI选型纠结?阶跃Step5Preview开放,高智低价长文本
Opus5的八分之一——同一笔预算换更强智能,或者同等能力以更低价格落地,两条路它都给铺了。修复、功能开发、重构、环境配置这类真实活儿都能接。
大模型领域, 长期以来一直被困在一个让大家都觉得没法解的困境里面, 这个困境就是所谓的只要能力很强那么价格就会非常贵, 如果想要价格便宜那么能力肯定是不行的。阶跃这家公司在今天做了一个动作, 把它的新一代旗舰级别的基础模型全部向大众开放了。
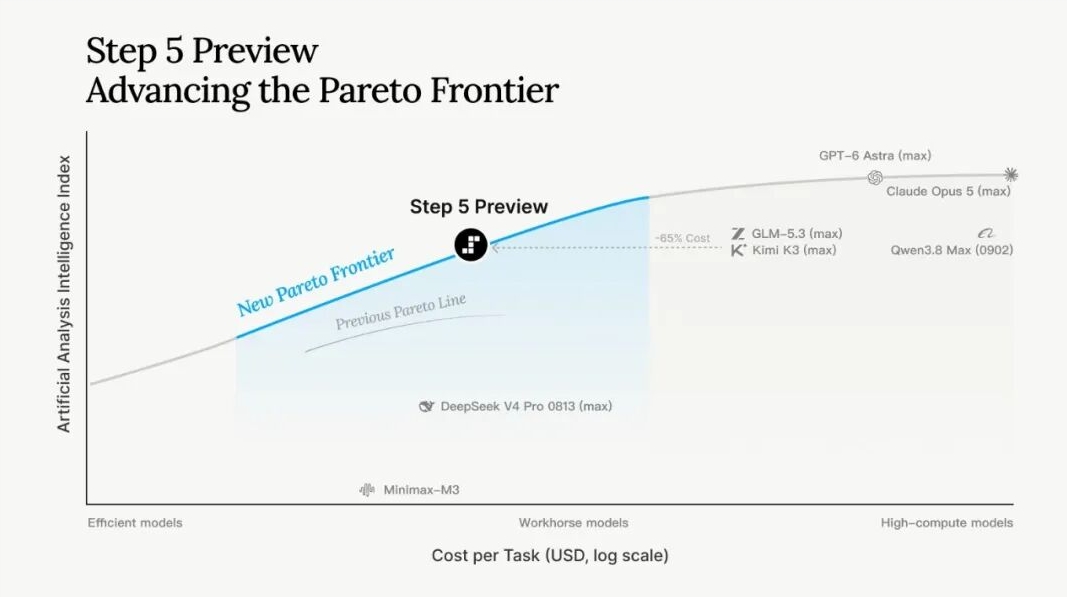
这个模型总共有600B的参数, 但是单次运行只需要激活27B的参数。在处理单个任务所需的成本方面, 只需要Opus5所需成本的八分之一就能够完成, 这一下就把所谓的帕累托边界往外推进了一格。
稀疏架构把成本打下来
总参数的数量是600B, 在每一次进行推理操作的时候, 只会激活其中的27B的参数量。这其实就是稀疏型专家混合架构, 也就是我们常说的稀疏MoE的一种核心设计思路。
因为不需要把全部的参数都塞进显存里面的空间去, 所以单块显卡进行部署的门槛就获得了大幅度的降低, 实际的推理成本被削减到了原来成本的非常低的一个零头比例, 这样一来, 即使是中小型规模的团队也能够让模型运行起来并能够跑得动整个过程。
在主流的那些进行Index评测的地方, 拿到了四十四分这么高的分数,成功挤进了全球开源类模型的前三甲的位置。当你拿着同一笔预算的时候, 既有可能去换成更加智能的效果, 也有可能用同等的一个能力去实现更加低价的一个落地方案, 这两条路都已经铺设好了, 完全不用去做什么单选题之类的选择。
百万上下文加视觉输入
它原生就支持有一百万Token长度的上下文窗口, 无论是把整个仓库的代码放进去, 还是把长期的研究报告塞进去, 或者是进行多轮的对话, 都是可以直接输入而不会导致负担过重的情况。
同时, 这个模型还能直接接受文本和图像这两种不同模态的内容, 不需要额外地去接上一个专门处理视觉的编码器了, 只用一套模型就可以搞定所有多模态的场景需求。
在金融投资研究的评测方面, 以及在对DRACO进行的跨领域深度研究当中, 它的表现紧挨着GPT系列模型和Opus5模型, 把其他那些参加了评审的开源模型远远地甩在了后面。关于SWE-bench v2的情况, 它也引入了截至9月19日为止的最新的统计结果数据。
编程不是跑分 是干真活
阶跃星自建的编程评测集, 它一共覆盖了 553 个独立的代码仓库, 涉及 9 类任务, 包含了 20 个应用领域, 还涵盖了 33 种不同的编程语言。
不论是 Bug 修复, 还是功能开发, 或者是重构工作, 亦或是环境配置这些在实际工作中常常出现的活儿, 这个评测集都完全可以接得住, 在跨场景的稳定性方面也能够稳稳地站得住。
在演示的过程里面, 它读取了关于ESP32的开发文档内容, 并且将一块ESP32-S3开发板进行了修改, 从而使其具备支持蓝牙按键以及语音输入的功能, 将其转化为Vibe键盘。
它自己打开了串口功能, 又调整了摄像头设置, 拍摄并截取设备图片, 还模拟了鼠标操作动作, 最后连修改代码和进行调试运行都亲力亲为, 整个过程耗时三个多小时才完成。
24小时自主优化GPU内核
把二十四小时的时间, 还有一张H100这样的设备交给它去用。它要从零点开始, 去优化MLA这个GPU的内核。具体来说, 头维度是五百一十二, 注意力头的数量是六十四个。
它会自己去修改代码, 然后运行内核, 再去测量吞吐的情况。要是发现某个方案虽然能跑通, 但是速度却降了下去, 它就会非常果断地把这个方案放弃掉。接着, 它会从那个表现最好的版本上面, 继续往上爬升级。
大约过了二十二个小时以后, 它的峰值性能压过了Opus5。
另外还有一项实验的时长同样是二十四小时, 在这项实验中, 借助自动化后续训练技术, Qwen3-30B-A3B的准确率实现了提升, 从原来的百分之五十三点三提高到了百分之六十, 最终结果与Opus5持平, 但在标注Token的节省方面更具优势。
金融研报和3D交互都能做
金融领域常常被当作是对综合能力进行检验的试金石, 围绕着公司研究这一套流程建立了三项内部评测工作, 另外还有涵盖了六类投资场景的外部基准库里面包括了二百二十道专家出的题目以及一万一千五百四十三项评分标准, 这四项成果全部都展现出了非常强大的结果。
在前端视觉方面, 它可以使用工具来建立三维资产, 并反复进行修改, 然后再接入 Three.js 制作交互应用和游戏。甚至可以从一本写于 1922 年的《广九铁路旅行指南》中抽取信息, 进而实现行程查询、费用计算以及路线回放等功能。
权重十月十五释放
从Step3到Step3.5, 阶跃押注的都是同一件事: 下一个阶段不是去堆更多的参数, 而是把参数用得更高效一些。这款开源旗舰的定位就是让Agent任务成为日常的主力工具。
完整模型权重将在10月15日那天正式发布。你可以想一想, 如果推理的成本能够再次减少一半的时间, 那么对于那些目前因为算力预算有限而导致项目无法运行的人群来说, 哪些人能够让这些项目直接就开始运作了呢?
欢迎你在评论区域发表你的看法, 同时也请记得为你的点赞和分享行为做出贡献, 以便让那些同样需要这些信息的技术伙伴们能够得到帮助。