Figure发布人形机器人Helix2.5 零样本任务成功率大幅提升至56%
结果显示,相比从零开始训练的同条件策略,Index预训练将零样本成功率从9%提升至56%。为隔离预训练贡献,Figure保持模型架构、优化方式、超参数、下游数据及评估条件一致,仅改变初始化方式。
在9月17日正式发布的那个版本中, 第五代模型把零样本的成功率一下子从百分之九提升到了百分之五十六, 看着效果很出色, 但是实际上为了这个结果, 花费了三百五十亿美元的算力成本以及一千五百万美元的数据采购费用。
把这笔总账算清楚之后就能发现, 虽然人形机器人想要真的进入到普通家庭里去干家务活还有很长的一段路要走, 差距非常大, 然而整体技术的发展方向确实是已经跑通了, 路子是对的。
测试环境刻意不重叠
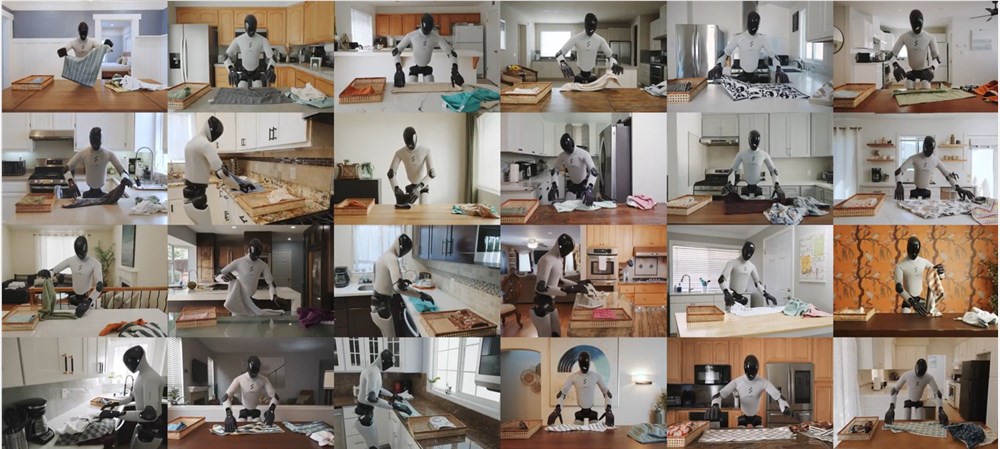
测试是在旧金山湾区的三十户家庭里进行的, 这三十户家庭此前没有任何数据被采集过。更关键的是, 测试中出现的玩具、毛巾和床上用品, 全部都不在训练任务的规范里。
也就是说, 机器人走进一个它没有见过的家, 面对的物件也是它没有见过的, 它从最开始就直接干活不经过之前的学习, 结果零样本的成功率依然做到了百分之五十六。
公司特意作出了强调, 在Index这个数据集中, 没有哪一项评估任务的占比是超过一点九零的。这代表预训练所带来的一些提升, 并不是靠着去背诵题目给背出来的, 而是说模型确实掌握了关于人类行为的那些通用规律, 即便换到了那种之前没见过的陌生场景里, 依然可以做到迁移。
三类动作撑起全身控制
优采云支持整理客厅、折叠毛巾和铺床这三类全身动作任务。评估时要求整个任务完整完成才算成功, 少一步都不行。折叠毛巾需要手指级别的精细操作。铺床则涉及身体大幅度前倾和手臂伸展。整理客厅更是要在走动中判断哪些要捡, 哪些要归位。
在测试环节, 版本号为 .5 的模型表现出了自我纠正的能力。它通过后退来调整位置, 更换站姿, 或者在床上移动身体。
用通俗的话来说, 这个机器人不仅仅能够执行动作, 更关键的是, 当它在动作进行一半时发现站姿不对, 或者是感到重心不稳的时候, 它能够自己把状态调整回来。这种能力对于人形机器人行业而言, 一直都是一个比较薄弱的环节。
一半数据打出同等成绩
只需要利用一半的适应数据, 其成功率就能达到和使用全部数据时差不多的水平。公司方面也同步开展了对照实验: 将模型架构、优化方式、超参数、下游数据以及评估条件全部固定不变, 仅针对初始化方式这一项进行改变。
其中一种方式采用基于Index的预训练方法, 另一种方式则是从零开始训练。最终得出的结果是, 9%与56%之间的显著差距, 完全是由预训练环节所导致的。
这个被称作一半数据的处理结果意味着什么? 这说明下游环节的适配成本可以被削减去一半。对于那些想要接入版本号5来做场景落地的团队而言,他们省下的标注时间以及节省下来的算力, 都是实实在在的钱。同时, 这也使得整套方案更容易在小规模团队的手中运行起来。
数据缩放规律首次量化
进一步开展的实验中, Index数据量是按照倍数逐渐增加的。也就是说, 每翻倍一次, 动作预测的损失值就会下降一个可以预估的程度。
公司依据这些结果, 绘制出了属于人形机器人领域的数据缩放曲线。这一举措, 实际上是为该领域的研究内容制定了一个判断标准, 用来衡量在数据层面是否出现了不足的情况或者达到了足够的水平。
在此之前, 人形机器人领域内部对于究竟需要采集多少数据才能训练出通用人工智能能力这件事, 基本上大家都是靠猜。
如今因为出现了一条明确的性能曲线, 所以后续大家投入多少计算资源、采集了多少视频资料、最终预期能达成几成的效果目标, 全部都已经有了可以量化衡量的参照标准, 从而不再是一片混乱、弄不清楚状况的糊涂局面。
Index数据集的规模和钱
Index 是在8月25日才刚刚推出来的, 一直到现在为止, 累计的下载次数已经达到了26.4万次, 每周活跃的用户数量超过了4.4万。
在数据方面, 已经积攒下了超过1600万个视频, 公司为了这事儿, 向数据贡献者付了1500万美元的钱款。这些视频所覆盖的内容是关于真实人类在居家的场景里的行为表现, 并非是那种在实验室里摆拍出来的动作。
1600万个视频、4.4万周活、26.4万下载, 这组数字说明Index已经不只是个学术数据集, 它正在变成一个有用户、有交易、有生态的开放平台。对开发者来说, 拿到Index等于拿到了人形机器人预训练的地基, 不用再自己从零搭数据管线。
35亿美元算力换来什么
公司在明确披露中说明, 他们已经投入了35亿美元的计算资源来专门训练Helix系列的模型, 而Helix.5就是其中的一环。要搞清楚这35亿美元到底是什么概念, 它大约相当于一座中型城市一整年的财政支出。
这笔钱几乎全部砸在了GPU集群和散热设施上。实际上, 用这笔钱购买的并不是某一台特定机器人的性能, 而是整个从“人类行为”转换到“机器人动作”的转化能力。
对于投资者还有产业链的下端来说, 那三十五亿的算力投入, 再加上那一千五百万的数据采购费, 这意思就表明了他们没把这当作是小打小闹的演示版本, 而是按照产品的层级标准在铺设基础的设备。
之后的那个5, 能不能从实验室里走出来, 进到工厂里面去, 或者进到普通的家庭里去, 这个关键就看靠着这三十五亿砸下去所弄出来的模型底座, 它的根基是不是足够扎实。
如果你手中拥有关于人形机器人的数据资料或者实际应用的场景案例, 你认为当前介绍的这套第五版预训练方案是否可以直接投入使用, 还是需要继续等待下一轮的技术迭代与优化?
非常欢迎你在下方的评论区域留言, 分享你对这一问题的具体看法和判断。如果你觉得这份内容的分析具有参考价值或实用意义, 不妨为该内容点赞支持一下, 并将其转发给那些对机器人技术领域保持关注的朋友。