雷神AI笔记本开售:本地跑120亿参数大模型,国补后仅1.99万元
雷神要给本地跑大模型这件事换个重量级解法。M7000将于明日(9月21日)上午10:00开售,号称能端侧驯服1200亿参数的大模型,首发叠加国补后到手价1.99万元。读卡器,接口布局透着一股工作站该有的样子。这种体量的模型不再非得仰仗专业显卡,普通消费级内存也能撑住长上下文的吞吐。
以前, 有人想要在自己的机器上面运行那个有一百二十B参数的超大模型, 要么就得去租用云端的资源, 要么就得拼命地增加显卡的数量, 这种成本是非常吓人的, 而且跑起来也不够自由。
到了九月二十一日那一天呢, 雷神把这个东西强行塞进了一台重量只有两点四五公斤的笔记本电脑里面, 这个首发加上国的补贴之后, 到手价是一万九千九百元, 这一举动直接把门槛给降低了好几刀。
端侧跑大模型到底难在哪
120B参数这个情况, 意思是模型权重本身就要占用几十GB的内存空间, 在现在这样的条件下, 普通的笔记本电脑配置的32GB内存根本都装不下这些数据物品, 回顾过去的日子, 人们往往只能去依靠专业显卡所具备的那几百GB显存资源进行支撑操作, 并且还需要通过直接申请的方式来参与机房的排队等待流程。
雷神这台设备在总体设计思路上选择去专门应对显存容量不够用这个问题, 具体做法是采用由六十四Gb内存搭配群联Ai SsD所提供的扩展解决办法, 通过将固态硬盘作为显存的额外延伸部分来处理相关事项, 在进行推理运算的时候把权重数据临时借用出来, 等使用完毕之后再归还回去, 从结果来看, 这就等同于在不知不觉间给内存扩大了双倍的使用容量。
那颗心脏是AMD锐龙
它的核心配置使用的是AMD锐龙AI Max+395处理器, 同时还搭配了64GB内存以及一块专门用来支持AI工作的固态硬盘。
另外, 系统在出厂的时候就预装了牧马人本地推理引擎, 所以用户一旦开机就可以直接投入工作使用, 完全没必要再去花费大把时间来折腾环境方面的配置, 也就省去了那种让人头疼的时间成本。
这台电脑配备了16英寸的2.5K屏幕, 拥有一个容量为99Wh的大电池, 这种大电池的配置足以支持一整天的通勤使用。此外, 设备还全面配备了2.5GbE网口以及UHS-II读卡器, 从这些接口的布局情况来看, 透着一股工作站应该具备的样子。
四大场景一次锁定
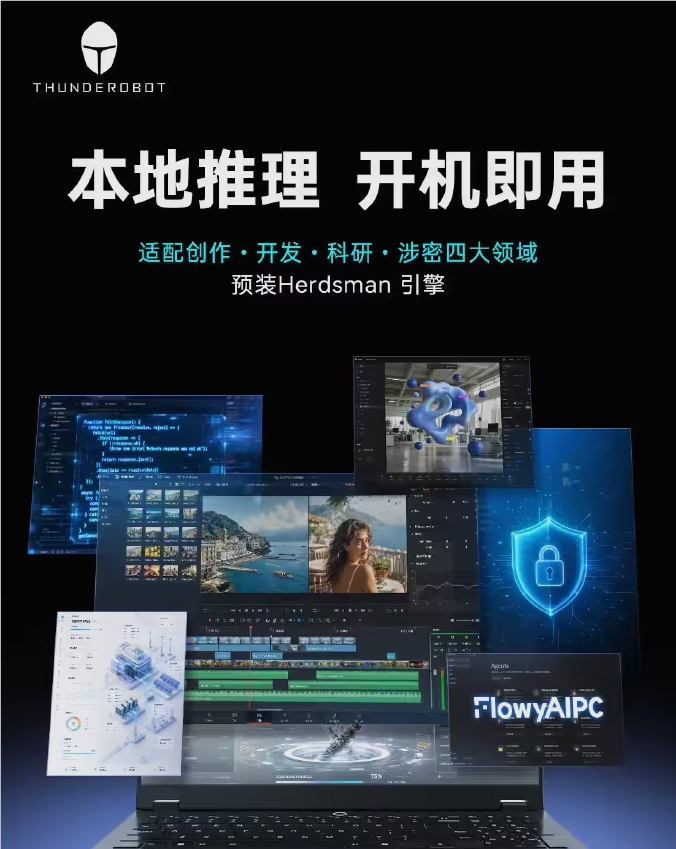
在创作场景里面, 本地推理意味着素材和提示词不会离开机器;在开发场景里面进行调试模型的时候, 不用等待云端应用程序编程接口的响应;在科研场景中面对敏感数据不怕外泄到第三方平台。
涉密场景是它最为独特的卖点。在单位内部, 对于那些不允许迁移至云端的项目, 现在只需要配备一台专用的计算机, 即可由单个人独立完成针对一千二百亿参数规模模型的运算流程, 彻底实现了业务闭环。此举使得相关人员无需再向相关部门申请使用机房资源, 也完全不必再经历排队等候显卡计算时间的漫长过程。
1.99万到底贵不贵
目前市面上有现成售卖的款式, 它配置了64GB的运行内存, 存储方面则是768GB的空间加上85GB的用于人工智能运算的固态存储设备, 在叠加了国家提供的补贴之后, 最终到手价为1.99万元, 如果你打算只单独购买一张RTX 4090级别的图形显示芯片, 那么花费需要两万元还多, 此外还需要另行考虑主板、运行内存、机箱以及电源这些部件的费用, 经过整体算下来,选择这整套方案实际上能够省下不少钱。
可是, 假如你仅仅只是偶尔运行一下那7B参数规模的小模型的话, 那么这确实就完全没有必要的去购置这一套配置方案了。它所锁定的目标用户群体是非常清楚的, 非常明确的, 那就是这类人群需要频繁地、重度地使用大语言模型, 并且对于隐私保护有极高的要求, 同时也极其不愿意被那些云计算厂商所捆绑和控制的人员。
群联那个方案才是关键
正是那个群联推出的存储扩大能力方案, 才使得编号为120B的模型能够运行在容量为64GB的运行内存之中, 并且还能实现流畅的文字生成工作。
在推理操作发生的时候, 该系统会从名为AI SSD的存储设备里读取所需的权重重构块到当前内存区域中, 一旦使用完毕就将其释放掉, 然后不断地进行这种循环往复的操作动作, 最终把数据吞吐速度提升到了最大极限状态。
像GPT-OSS-120B这样体量的模型, 靠着这套借力打力的办法, 也能够让长上下文的推理得以支撑下去。普通消费级别的内存, 不用再非得依靠专业显卡, 门槛实实在在地降低了一大截。
大模型推理正在退回到背包里
云端推理这种模式属于上一代的解决方案, 而桌面工作站则更早几代。在9月21日这天, 雷神采取的这一举措, 直接把端侧推理这项技术推进到了随身设备能够使用的新时代。该设备重达2.45公斤可以被装进通勤包里, 甚至可以在乘坐地铁的时候运行模型。
以后写代码可以这么做, 以后做设计也可以这么做, 还有跑实验的时候这么用。你只需要一个人待在一间会议室里, 就能把那个一百二十B的模型给填饱肚子了。完全不需要再排队等着使用那个图形处理器集群了, 也不会有人去担心在把数据传送到云端之后, 这个东西就再也收不回来去了的情况出现。
你手中那台设备, 它到底是不是足够使用, 这一点非常关键。请大家在评论区里面讨论一下这个情况。如果你认为这东西确实有实用价值, 那就请点击点赞按键, 并且把它转给朋友。那个朋友目前正在租赁云资源来进行模型运行操作。