小米开源CocktailASR-1,一键过滤噪音听清目标人声
该模型彻底改变了传统语音识别的任务输入方式,采用基于参考声纹的目标说话人识别机制。用户只需提供一段参考音频,模型便会利用声纹嵌入精准定位目标说话人,在多人混合音频中只转录该特定人物的语音,而其他人说话的内容、混响以及背景噪声均会被自动过滤,从而将复杂的混合音频任务转化为高效的目标说话人识别。
告别鸡尾酒会难题
嘈杂聚会场合中, 我们能轻松聚焦某个人谈话内容, 但传统语音识别系统面对多人同时说话却束手无策, 被称“鸡尾酒会难题”的这个行业痛点, 长久困扰着技术开发者, 直到小米近日正式開源-1大模型, 才真正实现突破。
传统ASR模型只可被动接收全部声音信号, 不能区分说话人身份, 在会议室里多人交叉对话之际, 模型会把所有人的话混著一起转录, 造成结果混乱不堪, 这一技术瓶颈始终制约着智能音箱、车载助手等设备的实用性提升。
参考声纹精准定位
本模型采用了一全新的输入形式, 使用者只需供给一段指标人物的参照音频, 体系就能提取声纹特质并正确锁定该说话人。在夹杂音频中, 模型会自动疏忽别的全体人的语音、回润教化和处境噪声, 仅转录指定人物的言语内容。
专用机制直接颠覆旧式语音识别固有逻辑。原来的工作是将混和音频原样转成字符, 当前的情况改为了在繁琐环境内取出专有声纹的精确侦测。录入时仅需把标引音频和目的单轨音频拼拢, 中间置入一秒间隔静音作为分隔方可。
底层架构突破创新
在架构设计的端到端方案采用了大语言模型, 由D2V2音频编码器和串联的大模型解码器组成。所有权重整合到同一个检查点中, 这种设计让模型有极佳的通用性, 无论单人说话或者多人混合的场景, 不用切换模型就可以直接处理。
开源代码已在GitHub按照.L0签署协议正式发布, 依赖环境极简, 仅需torch、numpy以及等基础库即可满足加载部署需求。使用者能便捷运行本地测试, 迅速集成入自身项目中, 以此大幅降低使用门槛。
测试数据表现惊艳
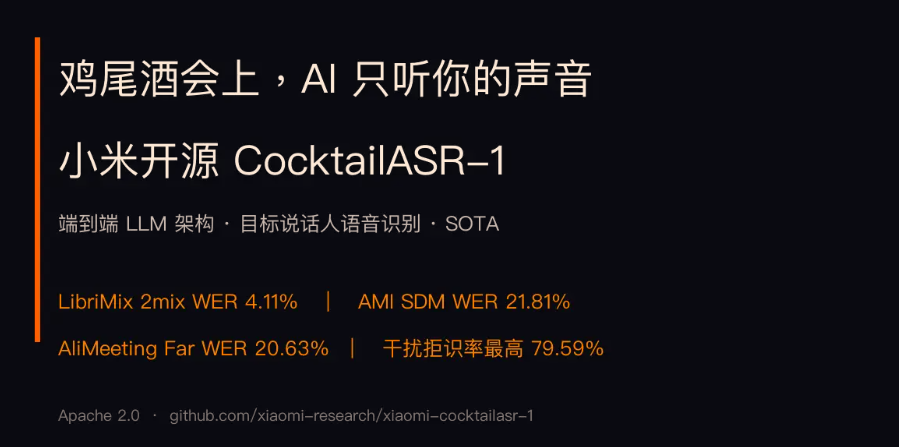
在模拟多说话人的基准测试中, 那个代号为-1的系统在数据集上的字错率仅有4.11%, 在另一套测试中更是低至2.90%。相对来说, 同一赛道方向的多款有名模型在混合场景里全军覆没, 部分对手型竞品的字错率高到了76%到121%, 但这个-1在该项测试里仅有12.29%。
具备更大挑战性真实会议场景中的例如AMI、SDM和Far测试里, 该模型和现有各类解决性方案相较同样实现了大幅领先。在于单人的场景环境之中, 它在数据集、以及-zh这类 benchmark之上同样也达成了全面的赶超, 进而显现出了碾压级的性能层面优势特质。
拒识与可解释功能
除了高精度的识别, -1还具备非常强大的负样本拒识能力不对。当对应着参考音频的人并没参与本次和当前的这场对话的时候, 模型会直接输出最终的空文本, 有力有效防止相关联的智能音箱或是车载这一类智能助手被旁人的实际声音错误触发, 这些这一功能, 在实际项目落地的日常场景当中极为特别关键。
模型同时支持的思维链推理功能, 能在输出最终答案前, 通过特定标签展示判断该说话人的推理过程,虽这一功能对识别精度影响极小, 却极大提升了系统的可解释性与调试的便利性, 同时方便了开发者排查各类问题。
技术应用前景广阔
小米此次的开源标志着语音识别的正从传统传统的“捕获所有声音”上转向面向聚焦锁定一个声音上的全新发展的阶段。这一技术的转向对于智能家居、智能化的车载设备与会展类的会议这类的系统上的应用等方面确实具有重要重大价值方面。未来可以有望去推动相关科技产品所具备的使用体验过程中的达到的质的质这样的飞跃了。
开发者只需做几步简单操作就能部署运行该模型于本地地, 不需复杂环境的配置之, 面向需要精准语音交互的产品而言者, 此方案提供了一个成熟的、工业级的解决方, 有望加速相关的应用场景的落地与普及。
你觉不觉这个技术最先能在哪个场景带来革命性的改变? 欢迎各位朋友去评论区分享看法和观点, 喜欢这篇文章的朋友一定要记得给它点赞还要帮忙转发出去!