金融推理大模型Alpha-R1开源,选票决策胜率飙升,投研人员必看
参数为基座,凭借独创的“语义门控”推理技术和两阶段强化学习训练框架,在金融推理任务的样本外评测中实现了对通用大模型与传统方法的全面大幅领先。在实际的金融投研场景中,传统的资产配置和通用大模型往往面临双重痛点。需要指出的是,该模型目前属于学术研究成果,相关论文、代码与模型已经全面开源。
AI下注金融市场,这次真的不一样了
财跃星辰和上海交通大学近期一款名为Alpha-R1金融的推理大模型开源了, 虽在8B参数但标普500和沪深300等任务上跑赢主流的通用模型幅度大幅, 它更关键的是不仅把决策逻辑讲得清楚, 还给了结果。
金融长期行业被问题一个困扰: 大模型新闻看很强, 落到投资决策上就失灵;传统统计方法虽稳定, 却经常”过时”。Alpha-R1试图打通这个断层, 让模型既能读懂市场, 又能动态选策略。
传统金融模型的两个致命短板
通用大模型最大的问题是死读书, 它能瞬间读完上千篇财经报道, 却不知道该用哪条信息去做相关联那种资产配置, 就如同那一个背下熟所有药方却压根不会看病的医生, 自身知识量十分大但一丁点都难以用得出来。
依赖历史相关性的PCA、PPO、SAC这些算法, 因为市场环境变化时只机械重复过去模式, 既不清楚策略为何有效, 也不清楚策略何时会失效, 所以传统统计方法的问题就在于“刻舟求剑”, 并且对变化的反应相当迟钝。
语义门控:让模型学会”看菜吃饭”
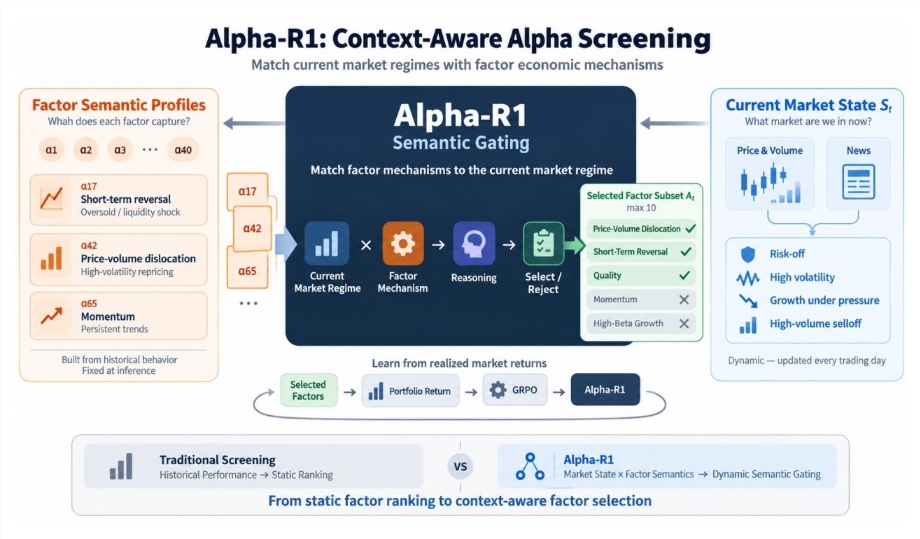
Alpha-R1的核心创新是”语义门控”技术。每次决策以前, 模型会综合实时行情和最新财经新闻, 生成一份”当前市场状态描述”。这一步很关键, 因为它让模型先理解自己处在什么环境里, 而非直接套用策略。
而后模型会将数目极多候选策略之“经济逻辑说明书”以及市场状态进行逐一比对。唯有逻辑契合的策略可被放行, 其余均遭拦截。此般做法完全变更了平均发力的方式, 达成了“当下该用何种策略”的智能判断。
用真金白银训练出来的模型
Alpha-R1训练分为俩阶段。第一阶段用数值方法筛选策略池候, 第二阶段再用语义能力行复筛。种两走的这种既保证策略候选数, 又确保了质量。
真正的杀手锏是GRPO强化学习环节, 全真模拟环境的奖励信号直接来自真实收益, 相当于用业绩成绩单反复打磨模型, 标普500任务去掉强化学习后, 年化收益从47.87%暴跌至12.85%的消融实验, 显示相关结论成立。
样本外测试证明泛化能力强
研究团队在用于训练的内容外, 利用2025年全部十二个月真实行情这些从未被观测到的数据做了样本外评测, 评测结果表现亮眼, 通用大模型中表现最优的那款, 在标普500和沪深300上的年化收益二者分别为百分之二十一点九四、百分之十四点六六, 相较Alpha-R1还差得较远。
更须要当心在意的是, 在罗素2000与中证1000这两类练习训练时从未触碰打仗过的存货行的股票池中, Alpha-R1也同异样样表示优良卓越佳, 这证实它并非依赖靠着去世记硬背僵记硬背数据信息材料数听数据, 倒是真正实在实在完全学会精通通透控制理解知悉相识看懂了然晓得领略清楚融会贯穿市场懂买卖市场并做出有用决议计划打算计划决策定夺。
不是黑箱,每一步都有据可查
这篇论文的附录详尽复盘了2025年4月9日出现的美股恐慌抛售日的应对决策过程, 彼时Alpha-R1精准地识别出市场内的恐慌抛售与短期波动显著放大, 在这一市场状态出现的同时, 果决地启用了短期价格偏离类策略, 还在此基础上下调了长周期策略。
模型不只给出操作建议, 还附上了条理清楚的调整理由。这种可解释性大幅压缩了金融模型”只给冷冰冰答案”的黑箱隐患, 让专业研究人员也能够核查和确认每一步决策的适应性。
AI金融领域实际应用的看法你怎么, 应用的金融领域AI看法你怎么? 分享在评论区, 别忘了点赞转发, 觉得有启发的话。